


Ответ на этот простой вопрос неожиданно окажется глубже, но перед тем как вы его зададите – десятки тысяч долларов уже будут потрачены на аренду серверов с GPU. Самостоятельный подбор под конкретный тип нагрузки хороший вариант, но требующий существенных вложений времени и ресурсов. Добиться того же результата можно иным способом.
Мы провели десятки тестов, чтобы дать вам конкретный вектор выбора, заведомо отсекая неподходящие варианты. Эта статья призвана сформировать более глубокое понимание того, какие характеристики GPU будут играть основную роль в типовых сценариях использования, а какими вполне можно пренебречь.
Обманчивость единой метрики
Наш мир очень сложен и за тысячи лет эволюции человеческий мозг хорошо научился экономить энергию за счёт упрощения обработки информации. Помимо очевидной пользы есть и побочный эффект – систематические ошибки и шаблонные отклонения в мышлении. Когда вы видите спецификацию GPU, то всегда находите какую-то цифру, которая интуитивно кажется “главной”, например VRAM. А затем происходит когнитивное искажение – “если по этой метрике эта карта на первом месте – значит она глобально топовая”.
Так наш мозг экономит ресурсы, убирая необходимость всестороннего анализа остальных характеристик и сводя неопределённость к единственно верному, по его мнению, выбору. Реальность же более прагматична – отталкиваться надо от конкретной нагрузки, каждая из которых зависит от совокупности метрик в том или ином GPU. Не менее важными являются характеристики серверной платформы – именно она часто является узким местом, мешающим достичь максимально эффективной утилизации вычислительных ресурсов.
У GPU нет какой-то одной определяющей силы. Вместо этого можно выделить 4-5 сочетаний характеристик, которые будут обладать разным “весом” в каждом конкретном сценарии применения.
Ну а если взглянуть на уровень выше, то инфраструктура провайдера будет играть не менее важную роль. Например, скорость локальной сети и latency влияют на эффективность работы распределённого инференс-кластера, ведь каждому узлу придётся обмениваться активациями, частичными результатами вычислений и сообщениями синхронизации. Если сеть не будет стабильной, то какими бы эффективными ни были GPU – достичь высокой производительности не получится.
Характеристики GPU
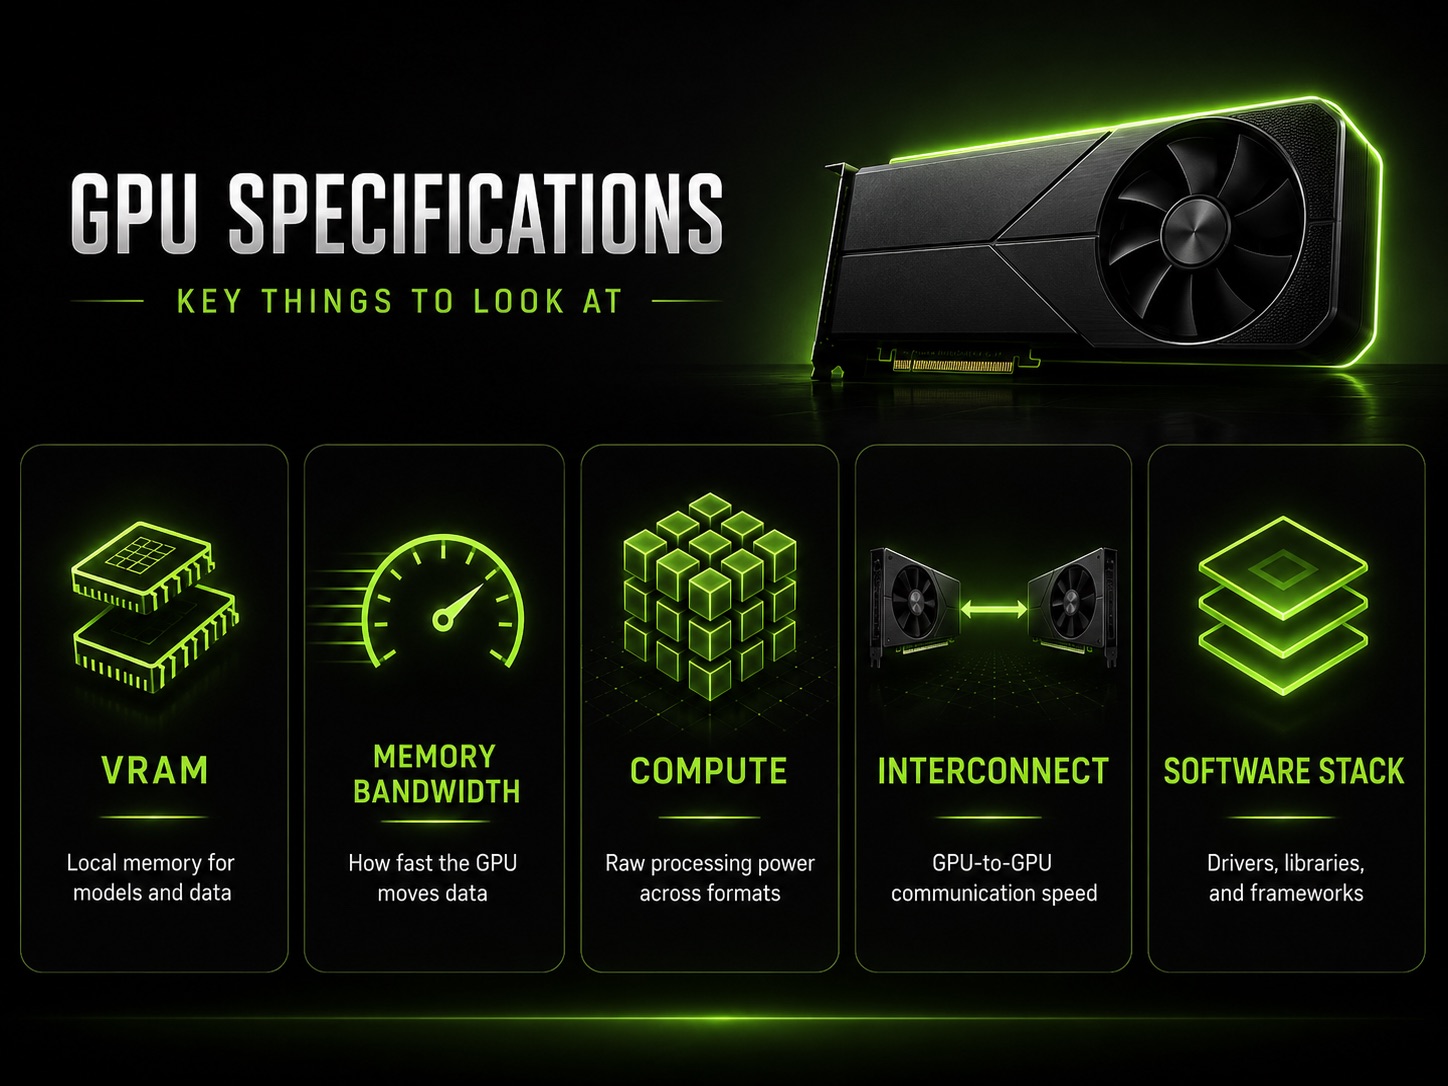
Перед тем как сравнивать производительность в разных сценариях, давайте разберёмся с основными параметрами GPU.
VRAM – это локальная память видеокарты, куда помещаются данные, необходимые во время вычислений. Например, если выполняется машинное обучение, то в неё попадают веса моделей, KV-кэш, промежуточные активации и прочие сопутствующие данные.
Memory bandwidth показывает насколько быстро GPU способен работать с VRAM. Это можно представить как ширину канала между вычислительными блоками GPU и чипами видеопамяти. Чем шире, тем больше данных можно переместить за единицу времени.
Compute – наиболее заметная в спецификациях GPU метрика, обычно указываемая в TFLOPS (Trillion Floating-Point Operations Per Second). Главное, что стоит учитывать – её нельзя рассматривать в отдельности от конкретного формата данных. Например, один и тот же GPU будет демонстрировать разную производительность на FP32 и FP8.
В дополнение к этой метрике часто указывается количество специализированных вычислительных блоков, например, Tensor Cores. Они не универсальны как CUDA-ядра, но оптимизированы для матричных операций, составляющих значительную часть вычислений при работе с нейронными сетями.
Interconnect – тип и ширина канала для общения GPU друг с другом. Пока модель помещается в VRAM одного GPU – вопроса обмена данными почти не возникает. Но как только встаёт задача инференса или обучения модели, которая в VRAM не влезает – придётся переходить на Multi-GPU конфигурацию и обмен данными между GPU может стать узким местом. Чтобы избежать этого используются высокоскоростные интерфейсы вроде NVlink вместо обычного PCIe.
Software stack важен не менее, чем выбор GPU. Каждый вендор строит собственную экосистему и от её зрелости будет зависеть реальная производительность, например Nvidia - CUDA, AMD - ROCm, Intel - OMIX или SynapseAI (для ускорителей Gaudi) и так далее.
Типовые сценарии
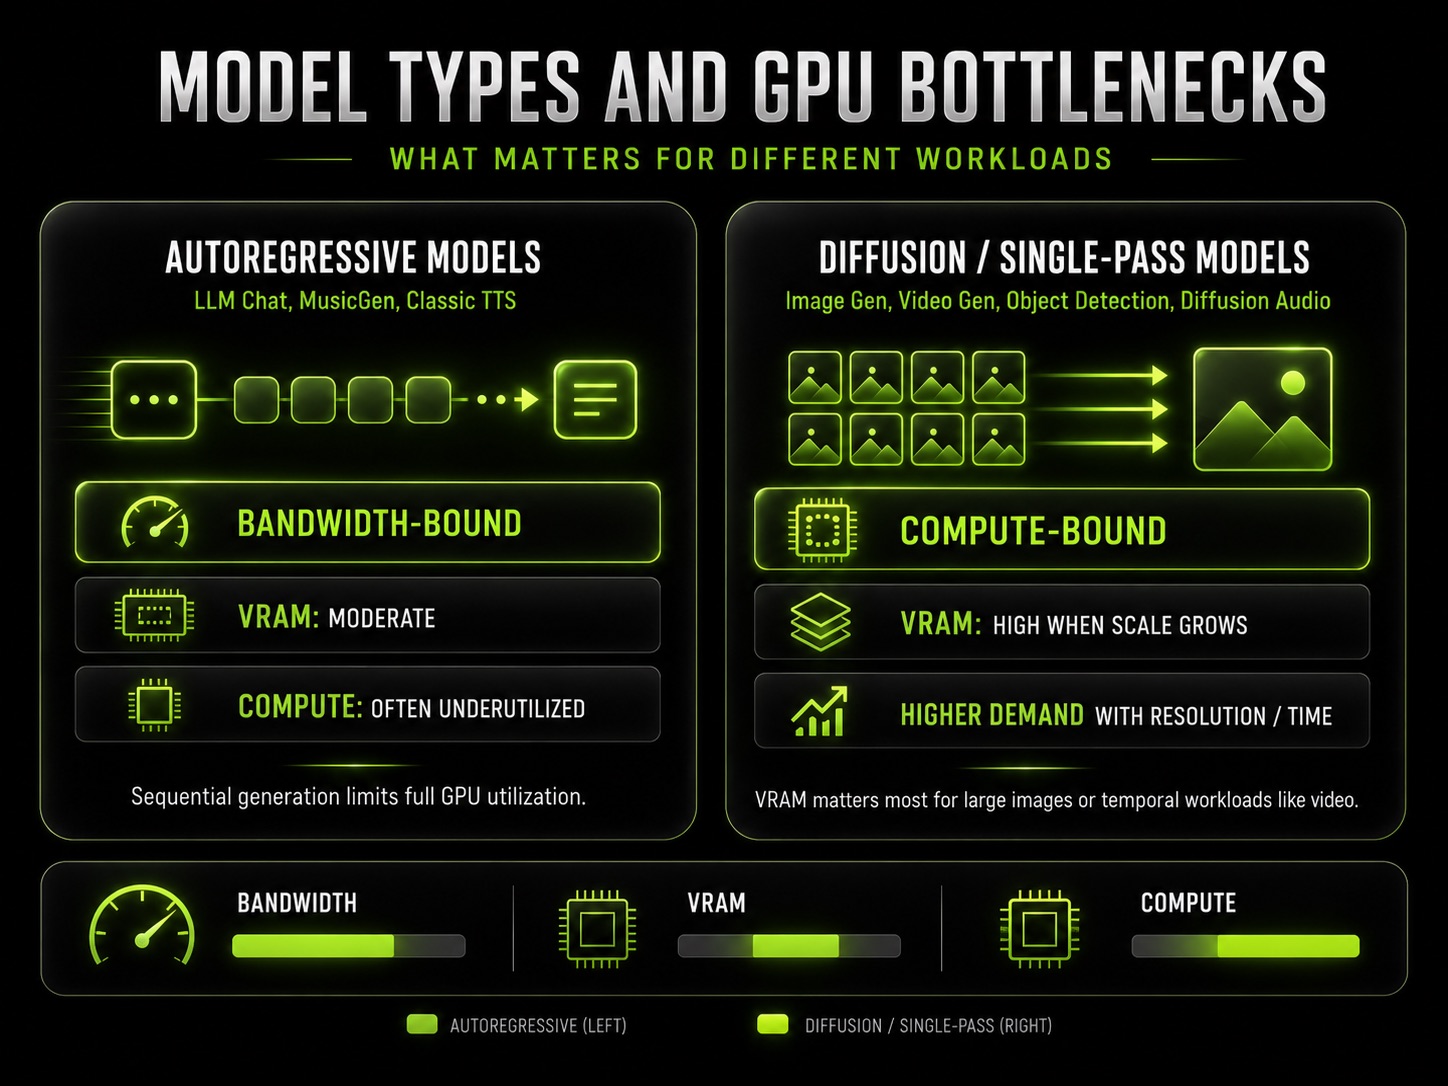
Среди нейросетей, рассматриваемых в этой статье чаще всего встречается два класса генеративных моделей:
- Авторегрессионные
LLM, модели для создания музыки и генерации голоса. Все они так или иначе прогнозируют будущее значение последовательности из предыдущих элементов. Например, если вы общаетесь с чат-ботом, то каждый следующий токен предсказывается исходя из предшествующих. - Диффузионные
Генерация изображений, звука и видео. Если очень упрощённо, то эти модели превращают случайный шум в репрезентативную выборку данных.
Для авторегрессионных моделей важна пропускная способность памяти и её размер в то время как вычислительная часть редко утилизируется на максимум. А вот для диффузионных моделей напротив главенствующую роль играет именно compute, а объём VRAM и пропускная способность начинает влиять только когда генерируются изображения или видео с высоким разрешением.
LLM в чате
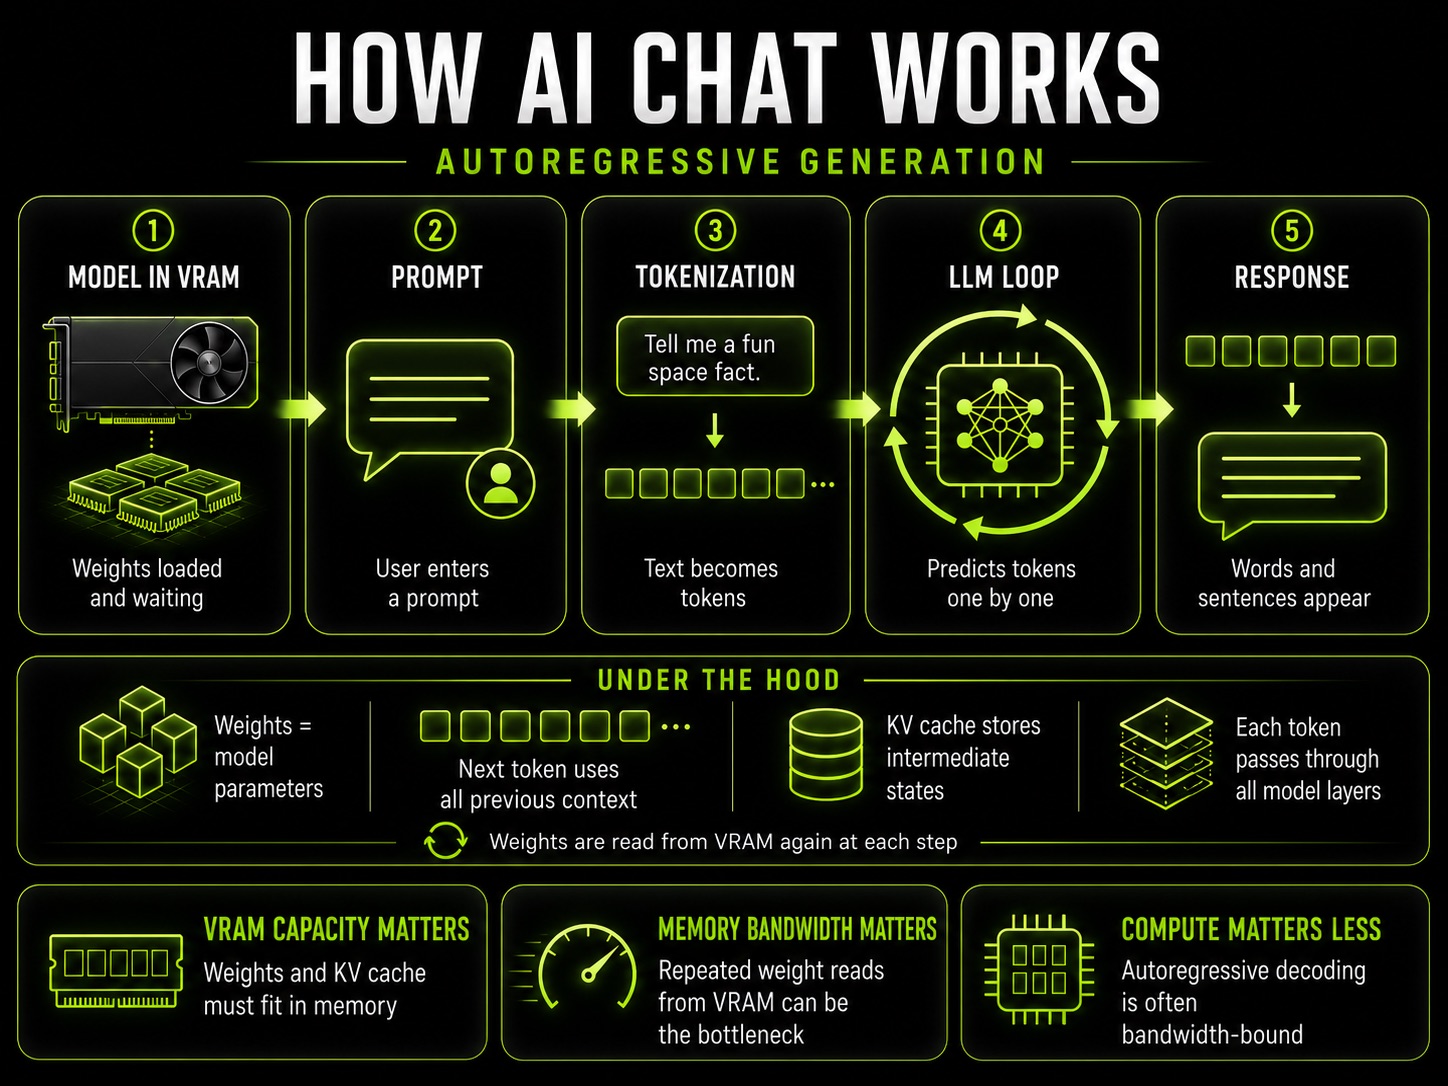
Классический чат с ИИ представляет собой типичную авторегрессионную генерацию. Модель загружается в VRAM и ожидает промпта от пользователя. Последний токенизируется – разбивается на небольшие кусочки и передаётся в LLM. Та в свою очередь начинает формировать ответ, циклично предсказывая токены друг за другом, создавая тем самым слова и выстраивая предложения.
Под капотом у LLM находится огромное количество чисел (параметров), которые ещё называют “весами”. Именно они влияют на то, какой токен будет сгенерирован следующим. При этом для прогнозирования, модели необходимо учитывать весь предыдущий контекст.
Чтобы не пересчитывать его с нуля на каждом шаге генерации, современные LLM сохраняют промежуточные результаты в KV-кэше, занимая часть видеопамяти. При этом новому токену необходимо пройти сквозь все слои, то есть веса снова считываются из VRAM. Это причина по которой авторегрессионные модели значительно больше зависят от объёма VRAM и её пропускной способности, чем от вычислительной части.
Справедливости ради отметим, что профиль нагрузки может меняться, поскольку обработка входного промпта хорошо распараллеливается и поэтому эта операция будет значительно больше утилизировать ресурсы вычислительных блоков, чем сама последовательная генерация токенов.
LLM для агентов
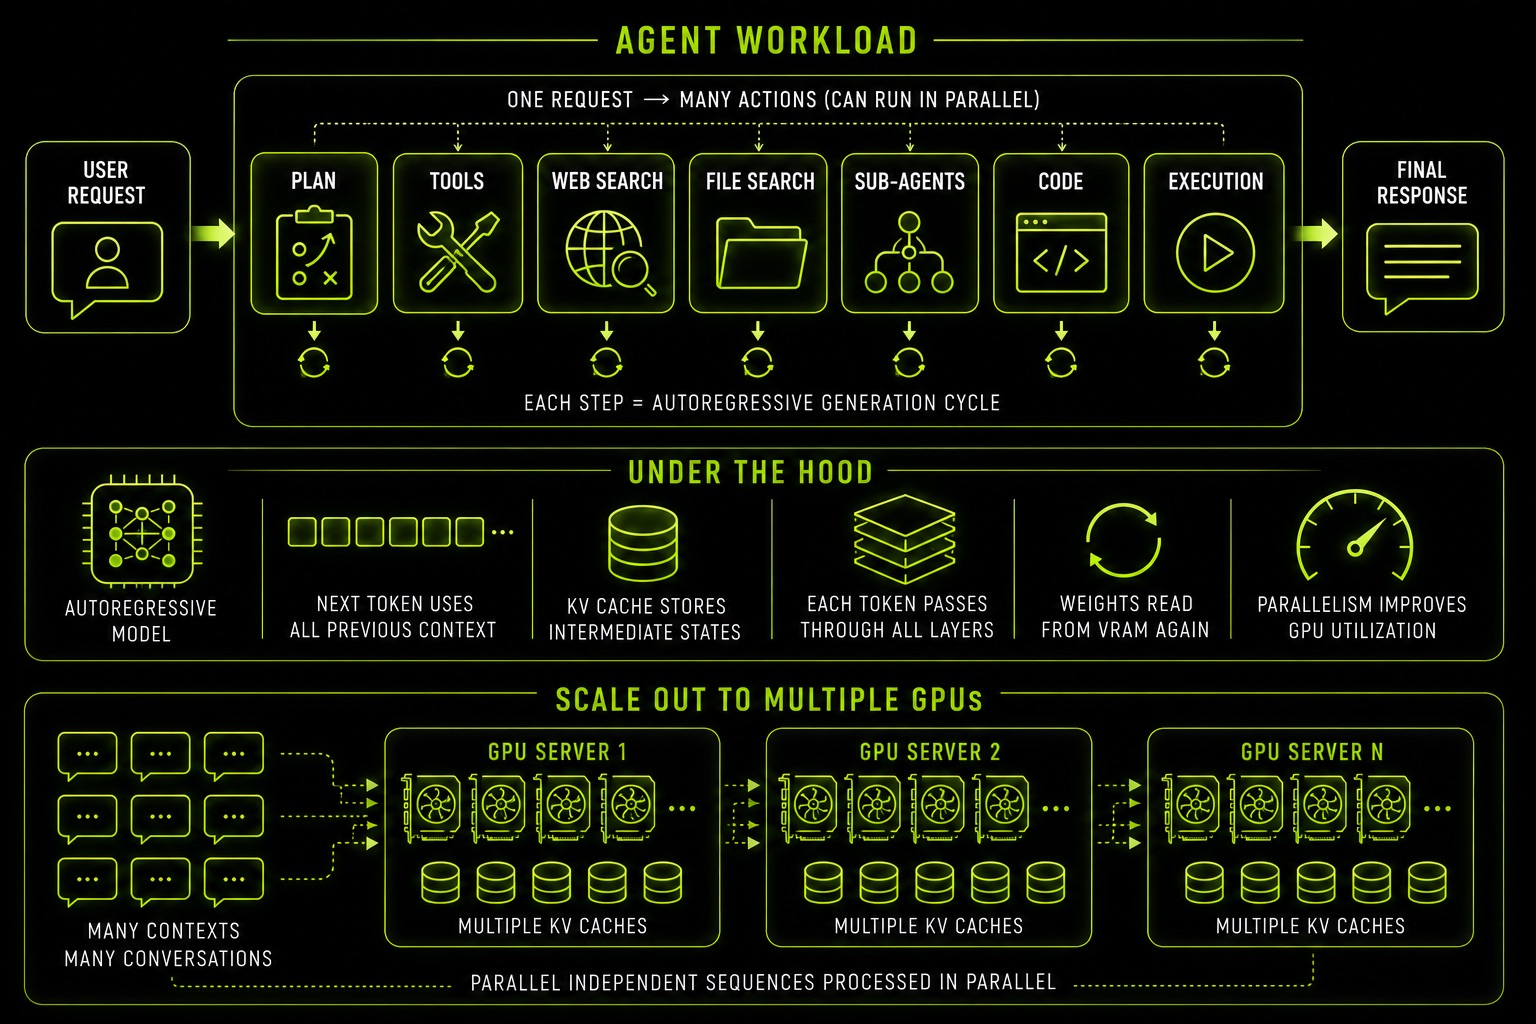
Внутри агентных систем нет фундаментальных изменений – это такие же вызовы авторегрессионных моделей, однако меняется характер рабочей нагрузки. Даже один пользовательский запрос способен запустить сложную последовательность, например:
- создавать планы действий,
- вызывать внешние инструменты,
- искать в интернете или локальных файлах,
- порождать субагентов,
- писать и выполнять программный код.
Многие такие шаги потребуют дополнительных обращений к LLM, а следовательно станут отдельным циклом авторегрессионной генерации. При этом агент старается решить задачу за минимально возможное время для чего некоторые задания запускаются параллельно, а не последовательно. Как результат – необходимость обслуживания множества контекстов и KV-кэшей.
Несмотря на то, что подобный характер нагрузки позволяет эффективнее использовать вычислительные блоки GPU, объём данных в VRAM может значительно вырастать. Поэтому для таких заданий часто применяют серверы с несколькими GPU, чтобы обрабатывать параллельно множество независимых последовательностей.
Распознавание речи
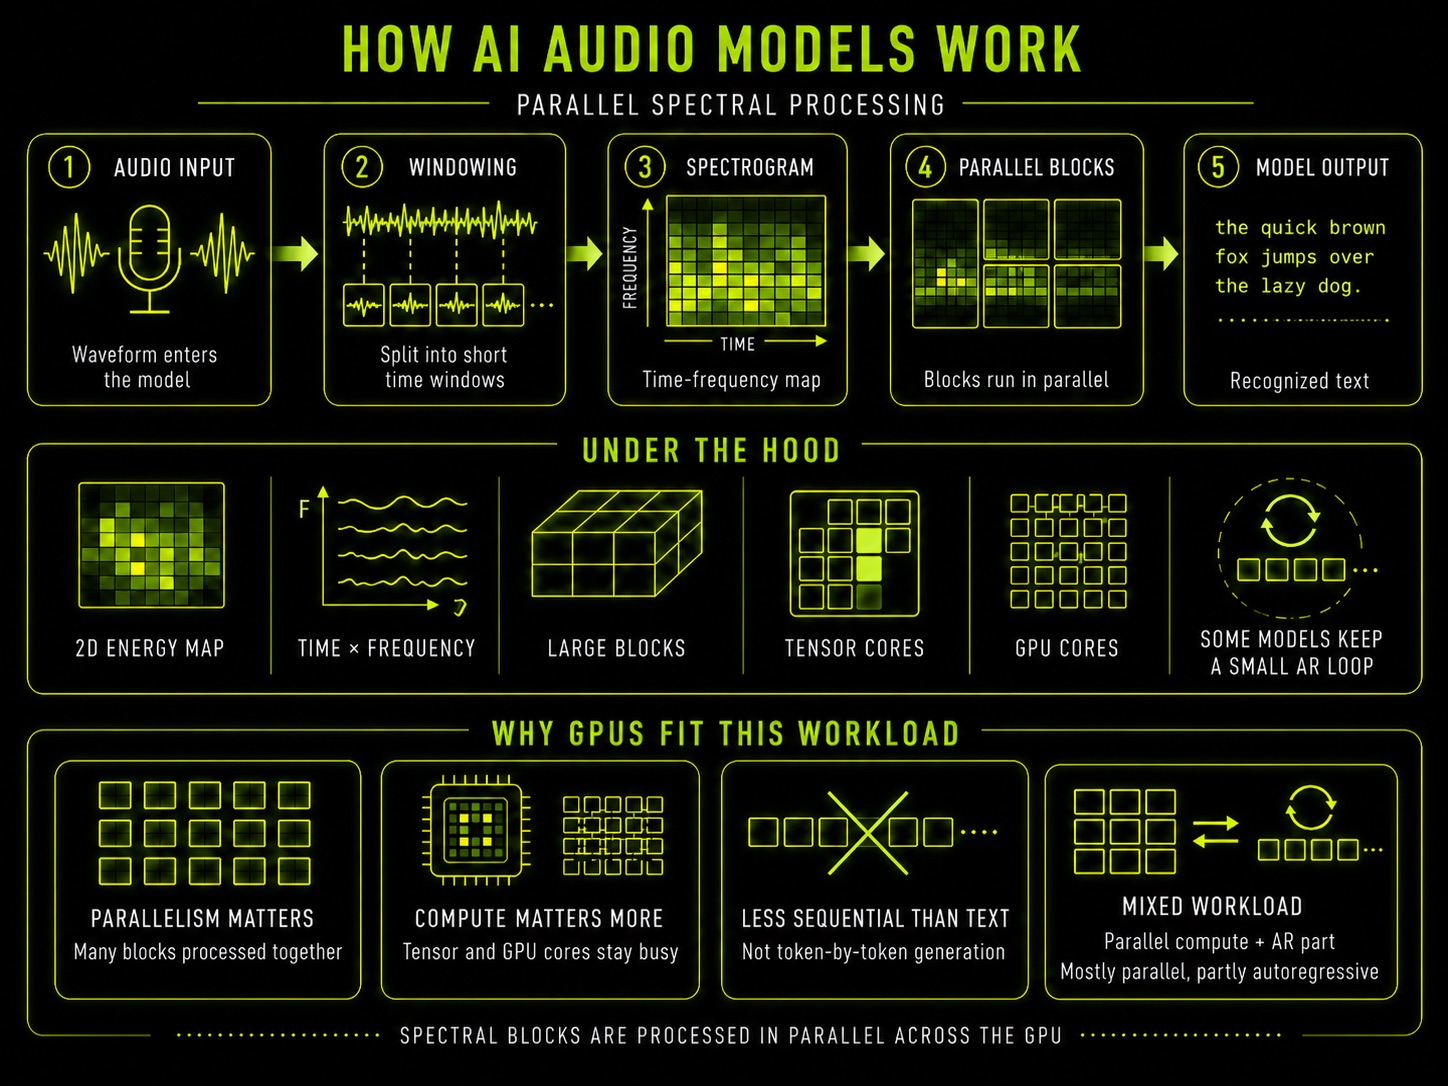
Ещё один тип нагрузки, хорошо подходящий для вычислений на GPU, но заметно отличающийся по характеру как от генерации текста, так и от диффузионных моделей. Чтобы понять, что именно меняется, давайте разберём по винтикам механизм работы подобных нейронных сетей.
В отличие от больших языковых моделей, здесь на вход система получает не текст, а аудиосигнал. На первом этапе его разбивают на короткие временные окна, а затем преобразуют в спектральное представление. По итогу модель получает своеобразную 2D карту распределения энергии по разным звуковым частотам во времени.
Её, в отличие от текста, можно разбить на большие блоки и обрабатывать параллельно, вместо генерации результата последовательными порциями. Этот тип нагрузки прекрасно выполняется на тензорных и универсальных вычислительных блоках GPU.
Справедливости ради стоит сказать, что некоторые системы всё равно содержат авторегрессионную часть. В этом случае задача представляет собой оба типа нагрузки, однако соотношение между ними часто будет в пользу параллельной обработки, а не авторегрессионной генерации.
Распознавание объектов в реальном времени
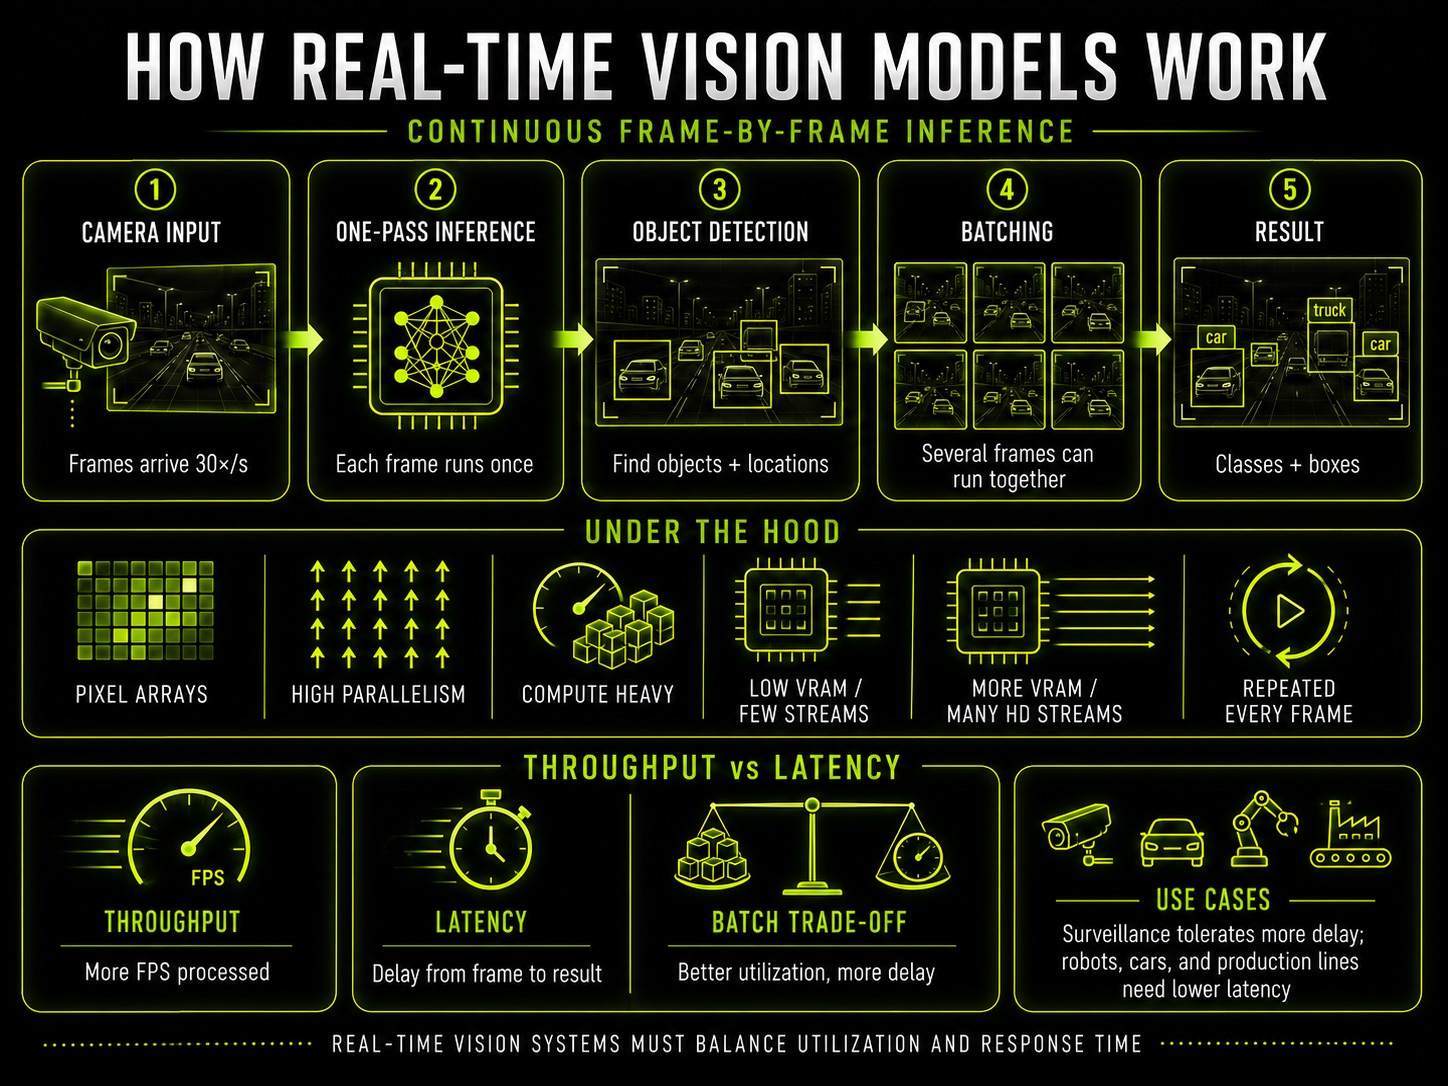
Этот тип нагрузки также выбивается из общего ряда. Тут нет генерации конкретного результата, а есть непрерывно повторяющийся инференс для каждого кадра. У детекторов вроде YOLO всё должно быть выполнено за один проход. Для работы в реальном времени система 30 раз в секунду принимает кадр, пропускает его через нейронную сеть, определяет объекты, а также где они расположены.
С точки зрения вычислений это большой массив пикселей, операции над которыми отлично распараллеливаются. Так что наиболее важным показателем будет являться compute, в то время как использование VRAM будет не слишком большим. Однако, это справедливо только когда обрабатывается один видеопоток. Но если у вас десятки камер высокого разрешения – это увеличит загрузку вычислительных блоков и потребует большего объёма видеопамяти.
Чтобы добиваться максимальной утилизации GPU можно выполнять вычисления не по одному изображению, а сразу группой из нескольких (batch). Но если одни кадры пришли, а другие нет – система будет их ждать, а не выполнять вычисления, тем самым увеличивая задержку между тем что видит камера и результатом распознавания.
Система требует поиска баланса двух параметров: throughput (сколько кадров в секунду способен обработать GPU) и latency (задержка от получения кадра до результата). В обычном видеонаблюдении задержка в пару сотен миллисекунд вполне приемлема, а вот если речь о промышленном роботе, автономном автомобиле или системе машинного зрения на производственной линии – тут требования могут быть гораздо жёстче.
Генерация изображений
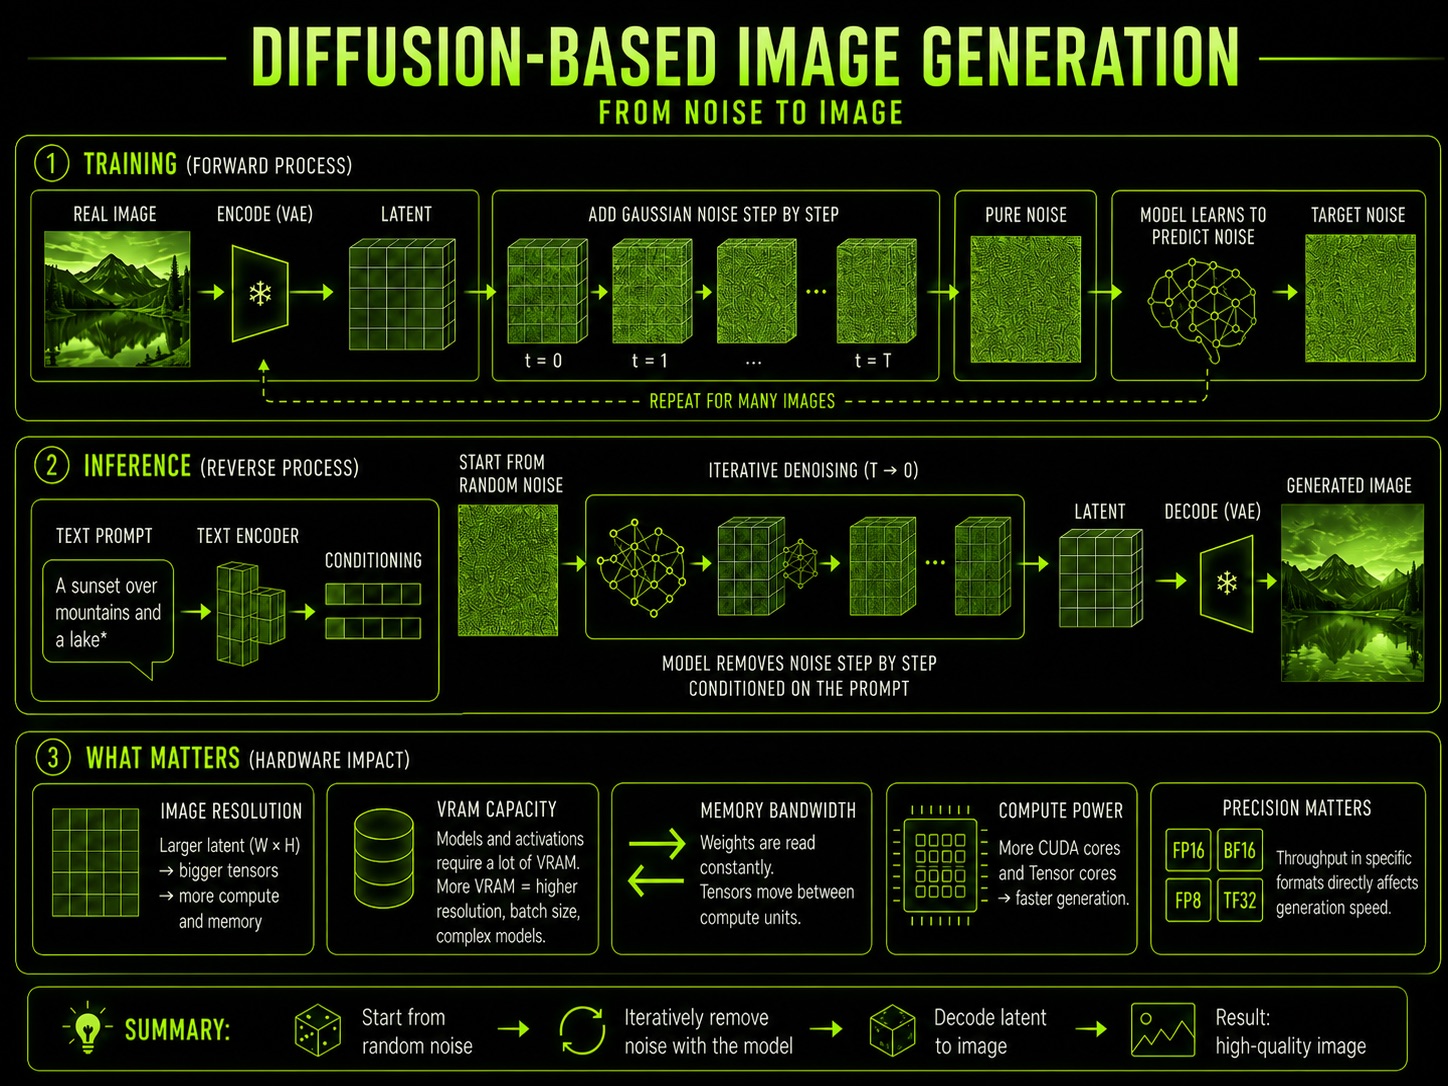
Подавляющее большинство современных нейросетей для генерации изображения относятся к классу диффузионных моделей. Несмотря на разницу в архитектурах все они так или иначе работают по принципу многократного удаления шума. Чтобы было понятнее, кратко опишем механику обучения и инференса.
На вход модели подаются изображения, переведённые в латентное пространство. Вместо самих пикселей используется их компактное математическое представление - латент. В процессе обучения на него поэтапно добавляется гауссов шум. Спустя множество итераций изображение становится практически неотличимым от случайного шума. При этом нейронная сеть учится предсказывать направление в котором зашумлённое представление надо изменить, чтобы приблизить его к исходным данным.
В процессе генерации всё происходит в обратном порядке. Пользовательский промпт преобразуется текстовым энкодером в набор числовых представлений. Вместе с этим создаётся “холст” – начальное латентное пространство, заполненное случайным шумом. Далее нейросеть многократно проходит по латенту, итеративно очищая его от шума с учётом промпта пользователя. После определённого количества проходов латент отправляется в VAE-декодер, выполняющий финальное преобразование в картинку.
Одним из факторов, существенно влияющим на профиль нагрузки является разрешение изображения. Чем больше ширина и высота латента, тем больше размер тензора, а следовательно и количество выполняемых операций и промежуточных активаций. Современные модели могут предъявлять высокие требования к VRAM и этот параметр придётся учитывать в первую очередь. Пропускная способность также важна, поскольку GPU приходится постоянно перечитывать веса и перемещать тензоры между вычислительными блоками.
Вместе с этим генерация изображений требовательна и к compute части. Так что количество CUDA и тензорных ядер будет напрямую влиять на скорость генерации. Можно ориентироваться на производительность карты в конкретных форматах, например FP16, BF16, FP8 и TF32.
Генерация видео
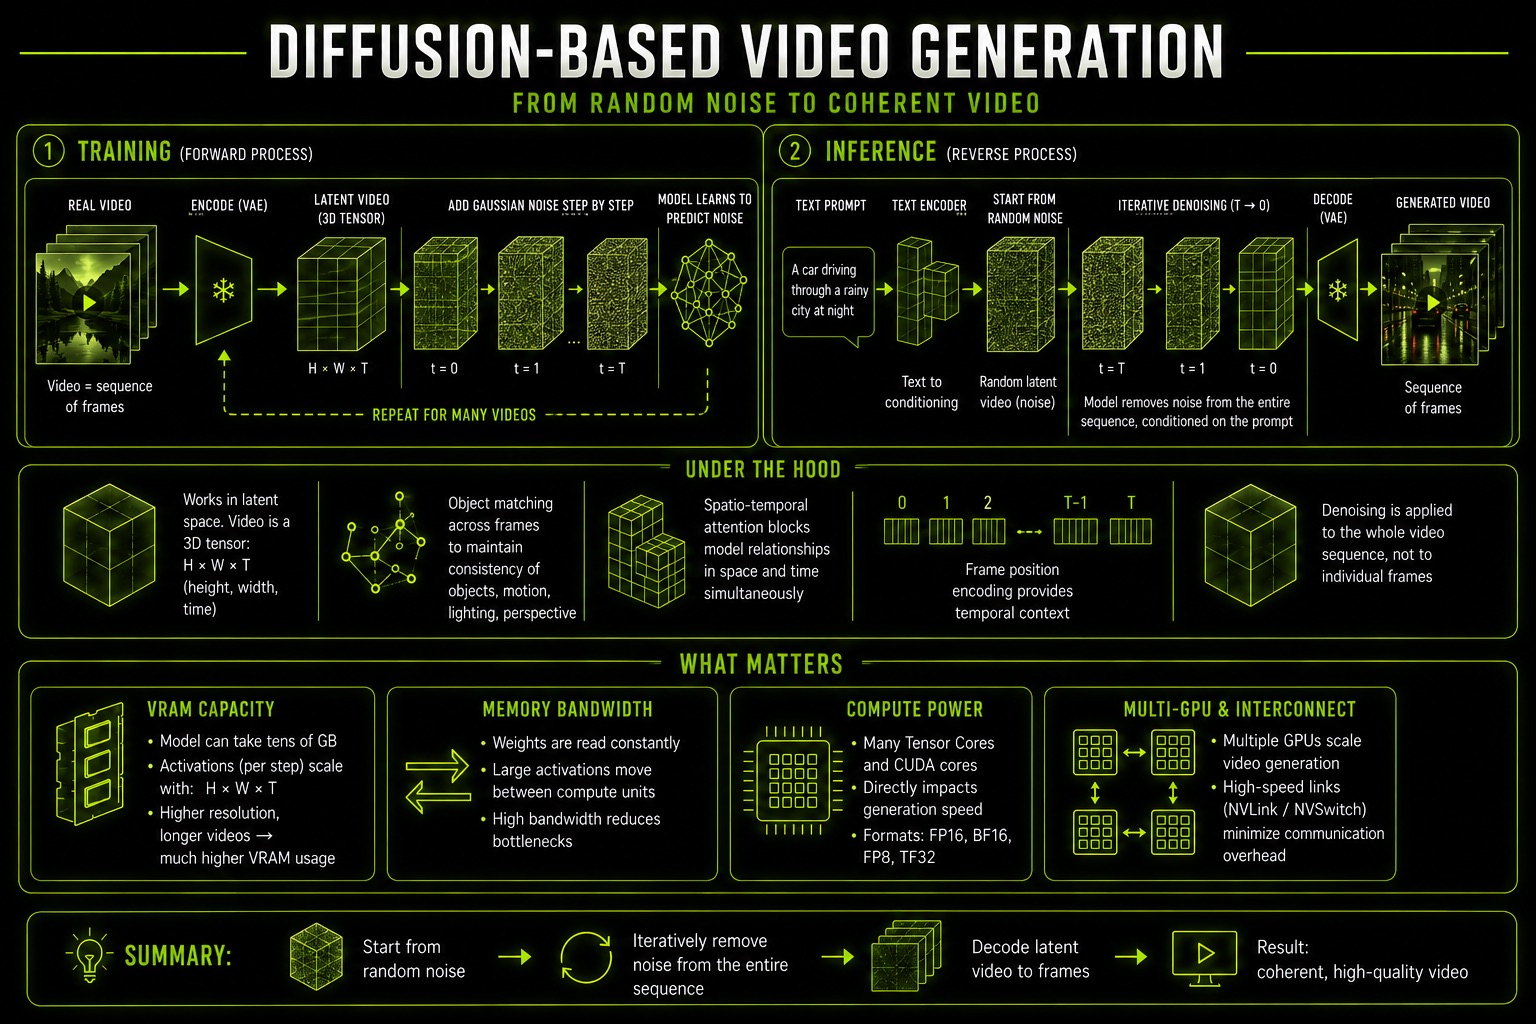
Любое видео – это последовательность кадров, так что базовый принцип тут такой же как и у обычной диффузионной генерации – модель начинает со случайного шума и доводит его до осмысленного визуального сигнала. Но вместе с этим задача сильно усложняется – на протяжении всей последовательности кадров необходимо сохранять консистентность объектов в кадре, их положение в пространстве, освещение, перспективу, направление движения и так далее. Вместо двух пространственных измерений добавляется ещё и третье – временное измерение.
Подобная нагрузка значительно более требовательна к GPU по сравнению с генерацией отдельных изображений. В архитектуре применяемых нейросетей добавляются алгоритмы сопоставления объектов, пространственно-временные блоки и кодировщики положения кадра.
Здесь также всё работает через латенты, однако процедура уменьшения шума производится не над одиночным кадром, а над всей последовательностью, чтобы движения объектов и изменения сцены формировались согласованно. Всё это приводит к быстрому росту потребления VRAM. Мало того, что сама модель легко занимает десятки гигабайт – значительная часть памяти будет расходоваться на промежуточные тензоры, создаваемые в процессе каждого прохода.
Для видеогенерации не получится выделить какую-то одну доминирующую характеристику. Объём и пропускная способность VRAM тут также важны, как и большое количество тензорных и CUDA-ядер. Для достижения высокой скорости нужны серверы с несколькими GPU, соединённых между собой широкой шиной, вроде NVlink.
Генерация музыки
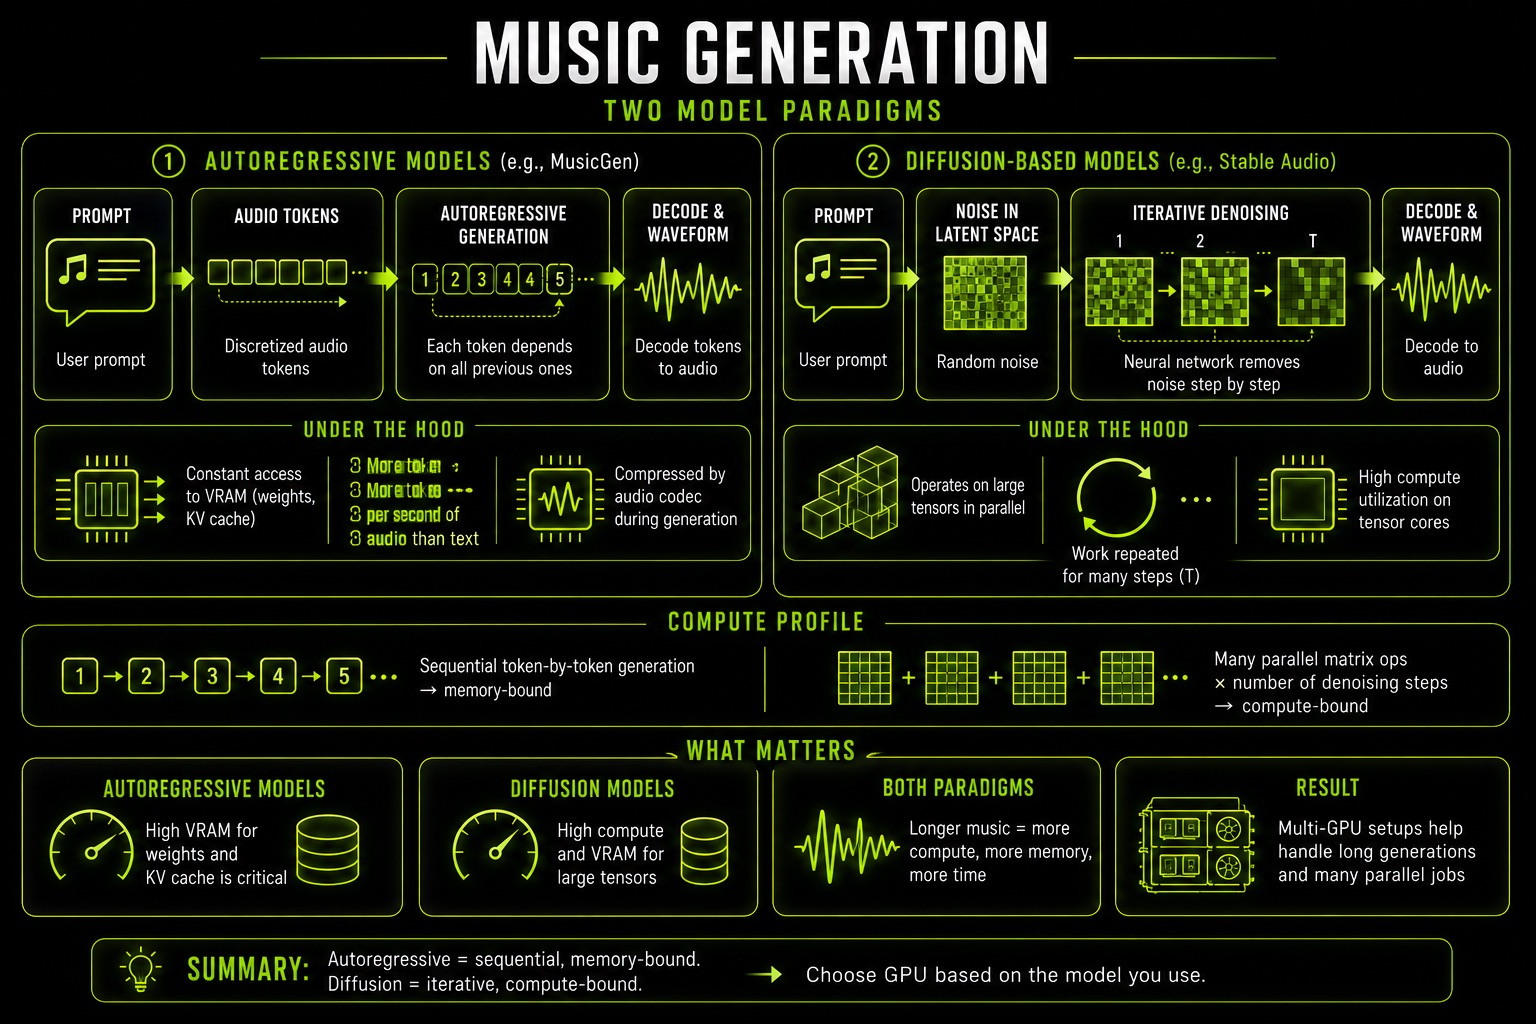
Для этого класса рабочих нагрузок подбор характеристик GPU придётся учитывать, исходя из применяемых моделей. Всё дело в том, что они есть обоих типов. Модели вроде MusicGen авторегрессивны. В них пользовательский промпт преобразуется в представление условного контекста, а затем система начинает предсказывать аудио токены один за другим, словно это языковая модель.
Каждый следующий аудио токен зависит от всех предыдущих и поэтому такая генерация в процессе инференса будет постоянно обращаться к VRAM. Каждая секунда музыки это множество токенов из нескольких кодовых книг, что требует значительно больше итераций, чем для генерации пары предложений текста. После того, как модель сгенерировала нужную последовательность, декодер восстанавливает из неё конечное представление, например, звуковой файл.
Однако, существует и отдельный большой пласт генераторов музыки, вроде Stable Audio, которые используют те же принципы, что и диффузионные генераторы изображений. В них модель начинает итеративно пропускать шум через нейронную сеть, каждый раз удаляя его фрагменты и конкретизируя итоговый сигнал. В отличие от авторегрессионных моделей тут нейросеть оперирует сразу большими тензорами, максимально утилизируя соответствующие ядра.
В конечном итоге профиль нагрузки будет выглядеть как множество параллельных матричных операций умноженных на количество шагов за которые шум в latent-представлении поэтапно убирается, формируя итоговые фрагменты. Так что тут будут важны и compute характеристики, и объём VRAM.
Выводы
Чтобы упростить выбор GPU под вашу рабочую нагрузку, мы подготовили для вас итоговую таблицу:
| Тип нагрузки | Ключевые характеристики | Второстепенные характеристики |
|---|---|---|
| LLM-чат | VRAM | Compute |
| LLM-агент | VRAM + compute | Interconnect |
| Распознавание речи | Compute | VRAM |
| Распознавание объектов | Compute, latency | VRAM |
| Генерация изображений | VRAM + compute | Bandwidth |
| Генерация видео | VRAM + compute | Interconnect, bandwidth |
| Генерация музыки | VRAM | Compute |
Универсального варианта, одинаково хорошо подходящего для всех сценариев, не существует, поэтому стоит учитывать характер рабочей нагрузки. Именно он может стать определяющим фактором построения оптимальной AI-инфраструктуры.


