


Последние 10 лет мультирегиональность находилась в категории best practice, но лишь крупные корпорации были готовы тратить бюджеты на такую избыточность. И если инциденты с подводными кабелями в Красном море ещё можно было воспринять, как случайность, то события марта 2026 года выводят риски для инфраструктуры на иной уровень.
Ошибка оператора или отказ железа теперь не самые страшные угрозы DR. Внезапно на первый план вышла физическая география и геополитика. Инфраструктура не существует в вакууме и теперь дата-центр даже в стабильном регионе может стать недоступным за 72 часа. Это новая реальность, которую нужно учитывать архитекторам инфраструктуры.
Парадокс хрупкости
Интернет поразительно устойчив. Это неудивительно - его предшественник, военная сеть ARPANET, изначально проектировался так, чтобы продолжать работать даже после разрушения значительной части инфраструктуры.
“Кровеносная система” интернета - подводные магистральные кабели. Через них проходит 95 процентов международного трафика. И именно с ними чаще всего связаны самые крупные инциденты в истории мировых телекоммуникаций. Несмотря на то, что такие кабели довольно крепкие, каждый год фиксируется до 200 случаев обрыва.
Часть из них, разумеется, чистая случайность или природные катастрофы. В 2022 году извержение вулкана полностью уничтожило подводный кабель, соединяющий островное Королевство Тонга с внешним миром. Целое государство, 110 000 человек, были отрезаны от мирового интернета.
Помимо естественных причин, кабели выходят из строя в результате намеренных действий. В 2024 году в Балтийском море были практически одновременно повреждены кабели, соединяющие Финляндию с Западной Европой (C-Lion1) и Швецию с Литвой (BCS East-West Interlink). Благо, оба этих инцидента практически никак не сказались на пользователях - помогла избыточность европейской сетевой инфраструктуры.
В том же 2024 году был ещё более показательный случай. Тонущее судно Rubymar в Красном море тащило за собой брошенный якорь, который легко порвал три подводных магистральных кабеля. Почти 90 процентов трафика между Европой и Азией попросту исчезло. Из-за того, что ремонтные суда не могли войти в зону конфликта - восстановление затянулось на месяцы.
Сентябрь 2025 - вновь Красное море. 4 крупнейших магистрали были одновременно перерезаны, вызвав мгновенную масштабную деградацию международной связности. Да, все пострадавшие провайдеры перешли на резервные маршруты, однако система справилась. Microsoft Azure сообщил свои клиентам о том, что сетевой трафик, идущий через Ближний Восток будет испытывать повышенную задержку.
Это лишь малая часть инцидентов, которая хорошо продемонстрировала индустрии насколько легко можно нарушить связность и этим вызвать проблемы как у бизнеса, так и у рядовых пользователей.
Форс-мажор как норма
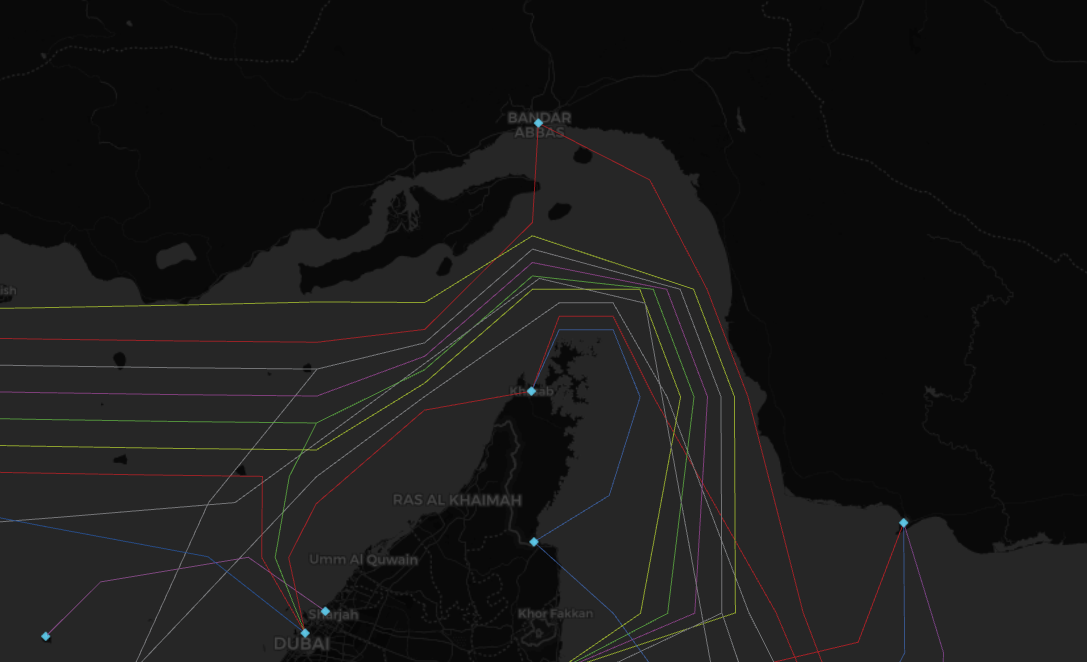
Подводные магистрали в Ормузском проливе (источник изображения -
Project Backbone)
Почти четверть мирового трафика проходит через 15 подводных кабелей (из 17 в Красном море), расположенных близко друг к другу в узком 30-километровом коридоре Баб-эль-Мандебского пролива. Последний же остаётся зоной повышенного военного риска. Дата-центры AWS в ОАЭ и Бахрейне подверглись атакам, вызвавших катастрофические последствия в виде пожаров, нарушения электроснабжения и физическое повреждение оборудования.
Внезапно оказалось, что центры обработки данных необходимо защищать не только от стихийных бедствий и киберугроз. Они стали потенциальными целями, безопасность которых требуется обеспечивать на государственном уровне. Страны Персидского залива потратили миллиарды долларов на построение отказоустойчивой вычислительной инфраструктуры для развития искусственного интеллекта, а теперь выясняется, что она попросту не рассчитана на то, что кто-то будет целенаправленно уничтожать объекты внутри одного региона.
Апогеем ситуации стало публичное заявление AWS. В нём он категорично предлагает клиентам выполнить миграцию своих нагрузок в другие регионы. Приведём его дословно, прямо из дашборда:
Зоны доступности больше не работают
Если посмотреть на традиционную архитектуру отказоустойчивого облака, то большинство крупных провайдеров использует деление на регионы, внутри которых есть несколько зон доступности (Availability Zones, AZ). В составе каждой AZ может быть один или несколько физических дата-центров, но все они представляют собой единый домен отказа.
Для клиента фактически виден только AZ, а всё, что происходит на уровне ниже - внутреннее дело провайдера. Поэтому в большинстве случаев работал классический подход по принципу Multi-AZ. Репликация баз данных, балансировка нагрузки и распределённые очереди - всё это разделялось между AZ, поскольку это закрывало большинство инцидентов (от отказа железа до плановых работ).
Но у такой модели есть неочевидный нюанс. Для синхронной репликации между ЦОДами в рамках AZ нужно, чтобы они были довольно близко друг к другу. Каждая сотня километров выливается в 1 лишнюю мс (туда-обратно 2 мс). Разумеется, это очень грубая оценка. Увеличение задержки потенциально сделает такую репликацию нецелесообразной. Ну а в реальной жизни, можно предположить, что все 3 зоны условного ME-CENTRAL-1 находятся в пределах агломерации Дубая. Конкретные города или координаты дата-центров AWS намеренно не раскрывает, что впрочем не стало препятствием для разведки Ирана.
В итоге, слабым местом оказалось то, что система изначально была рассчитана на отказ одной зоны доступности, а атака поразила две из трёх. Вместо независимых, пускай и серьёзных отказов, архитектура получила скоординированный удар по одной географической точке.
Что делать архитектору в таких условиях
Мартовские события - наглядное подтверждение, что пора пересмотреть модель угроз и убрать из неё негласное допущение о том, что регион - достаточная и устойчивая единица изоляции. Но прежде чем переходить непосредственно к проектированию нужно ответить на неудобный вопрос - сколько стоит для компании час простоя? Готов ли бизнес к тому, чтобы пролежать несколько часов или даже суток?
Ответ станет ключом к тому, какую стратегию DR выбрать. Если взять за основу 4 стандартных стратегии AWS, то можно составить такую таблицу:
| Стратегия | RTO | RPO | Стоимость |
|---|---|---|---|
| Backup & Restore | часы-сутки | часы | $ |
| Pilot Light | десятки минут | минуты | $$ |
| Warm Standby | минуты | секунды | $$$ |
| Active-Active | секунды | ~0 | $$$$ |
Скажем честно - большинству компаний Active-Active не нужен. Однако если регион становится возможным доменом отказа, то Backup & Restore будет недостаточно.
Выбор региона
При построении мультирегиональной инфраструктуры нужно обратить особое внимание на их независимость друг от друга не только на географическом уровне. У них должны отсутствовать общие узкие места и они должны быть подключены к разным физическим магистралям. Внимание стоит уделить и тому, чтобы регионы находились в разной юрисдикции и не имели общего политического периметра.
На примере того же AWS - пара ME-CENTRAL-1 и ME-SOUTH-1 в марте 2026 года не являлась разумным выбором. Формально да - это разные регионы, но если взглянуть на них с точки зрения устойчивости бизнеса, то оба они сильно зависимы друг от друга. Единый политический контур и ограниченный выбор транзитных маршрутов способствуют тому, что регионы могут повести себя не как два независимых домена отказа, а как один.
Из вышесказанного получается очень простой вывод - мультирегиональный DR нужно проектировать не между парой ближайших регионов, а между двумя наименее связанными площадками, которые укладываются в требования бизнеса. Однако, даже мультирегиональная схема порой оставляет общие зависимости.
Сломаться может не только compute, но и на уровне DNS, платёжного шлюза, каналов связи с офисом и тому подобные сервисы. Если они остаются единой точкой отказа, то наличие второго региона не спасёт, а скорее создаст дорогую иллюзию резервирования. К тому же само по себе реплицирование данных во второй регион - это вовсе не гарантия восстановления.
От абстракций к практике
Задайте себе вопрос - в каком состоянии окажется система после переключения? Запустится ли приложение, сможет ли подтянуть актуальные секреты, не сломаются ли интеграции, будут ли доступны очереди и не выйдет ли так, что все события начнут массово дублироваться в системе. Вместо абстрактного “у нас есть DR?” всё сводится к более простому и конкретному набору вопросов, а именно:
- что считаем реалистичным сценарием отказа;
- какие компоненты должны выжить при потере региона;
- что переключаем руками, а что автоматически;
- кто принимает решение о том, что надо выполнить переключение;
- как предотвращаем ситуацию со split-brain и потерей консистентности данных;
- порядок возвращения назад после восстановления главной площадки.
Ответив на них становится ясно, что второй регион должен не просто быть хранилищем бэкапов, а заранее подготовленным контуром, который содержит минимально необходимый набор сервисов и проверенный механизм переключения. Это ровно тот уровень зрелости, позволяющий пережить потерю региона для большинства компаний без существенного удара по бюджету.
Отдельно стоит определить какие данные можно потерять, а какие нет. Если у вас stateful-сервисы, то тут практически нет возможности сэкономить. Достигнуть околонулевого RPO - нетривиальная инженерная задача, решение которой будет напрямую влиять на общую производительность, стоимость и сложность эксплуатации.
Тестирование и симуляция отказов как часть дизайна
В море на больших судах команда регулярно проводит тренировки по имитации разных аварийных ситуаций. Тут тоже самое - DR-архитектура должна существовать не только на бумаге. Здесь нет вопроса “можем ли мы переключиться”, тут должен задаваться: “когда мы в последний раз по-настоящему переключались”. Если такой failover ни разу не выполнялся - это плохой знак. Все оценки RTO и RPO остаются исключительно теоретическими, по факту вы не знаете как себя поведёт инфраструктура в реальной ситуации.
Приобретение практических навыков должно включать в себя не только периодические “учения” по потере региона целиком, но и замеры фактических значений RTO/RPO. Кроме того должна быть отдельная отработка возвращения в основной регион, после восстановления его работоспособности.
Итог
Учиться лучше на чужих ошибках. В марте 2026 года мы увидели наглядный пример ситуации, которая могла быть предсказана, но вероятность её возникновения оказалась недооценена. Регион - больше не гарантированная граница отказа, а мультирегиональный DR становится элементом базового архитектурного решения.
Глобально же ничего не поменялось - это не повод сломя голову пытаться выстроить Active-Active c почти нулевым failover. Но всё же для тех, чей бизнес может пострадать от более-менее длительного простоя есть вполне прагматичная рекомендация задуматься о переходе на следующий уровень DR, разнося его по разным регионам.
Так, в критический момент вы будете точно знать, что ваш резервный регион существует не просто на бумаге - он готов принять нагрузку за адекватное время. И именно такая ситуация лучше всего покажет бизнесу почему вы тратите дополнительные ресурсы на обеспечение избыточной инфраструктуры.


